怎样把欧洲推理服务落到英国服务器:从0到1的成本账与选型清单
先算清场景:矩阵站群为什么要自己跑欧洲推理
做欧洲多语种矩阵站群的团队,最近一年普遍遇到同一个需求:几十上百个站点要批量生成标题、产品描述、FAQ、结构化内容,还要做语义内链和关键词聚类。用公有云 API,单次调用几分钱看着不多,但乘以每天几千篇、每篇十几次调用,一个月账单很容易冲到几百到上千美元,而且语料要出境,遇到 GDPR 相关的客户尽调时解释成本很高。于是自建一套小规模推理服务,放在英国机房,服务欧洲访客,成了一条现实路径。
英国的优势在于:伦敦是欧洲金融与商业中心,到德国、法国、荷兰、爱尔兰的陆缆与海缆路径短,BGP智能路由通常能把西欧主要城市的往返延迟压在 20~40ms 量级;同时英国的数据保护框架与欧盟 GDPR 基本对齐,做欧洲业务的合规叙事相对顺畅。代价是带宽与机柜成本高于东欧,需要做延迟与预算的权衡。
成本账拆开算:一次推理请求到底花在哪
自建推理的成本由四块构成,按量级估算(价格随服务商与汇率浮动,以下只给区间):
- 算力:跑 7B~14B 量化模型做文本生成,单张 24G 显存级别的 GPU 通常够用;欧洲机房这类物理GPU月租普遍在数千元量级,云GPU按小时计费则更贵。若只是批量内容生成、并发不高,直接用高主频 CPU + 小模型量化推理也能跑,成本能压到每月几百元。
- 服务器与带宽:推理服务本身吃带宽不多,真正吃带宽的是站群页面与图片回源。英国机房 100M 独享与 500M 独享的价差通常在一两百元/月量级,但对多站点并发抓取体验差别明显。
- 合规与运维:包括数据处理协议、日志留存策略、备份。多数团队用「自建 + 第三方审计模板」的方式,成本主要是人力。
- 隐性成本:模型更新、提示词调优、失败重试。API 方案这块是服务商承担,自建则要自己扛,通常要预留 20%~30% 的额外机器余量。
结论:当每日生成量稳定超过数千次调用、且需要长期跑,自建英国推理节点的回本周期一般在 2~4 个月;量小的时候先用 API 更划算。
从0到1落地:机器怎么配、步骤怎么走
落地顺序建议按这个流程:
- 定模型与量化:优先选 Llama、Qwen、DeepSeek 这类可私有化部署的开源模型,7B~14B 用 4bit 量化,显存占用通常能控制在 8~16G。
- 估并发:站群内容生成多为批处理,单卡串行即可;若要支撑编辑实时改写,按每路并发预留 2~4G 显存估算。
- 选机型:CPU 推理选高主频多核 + 32G 以上内存;GPU 推理选独享显卡、明确不超售的物理机或独享云主机。
- 装环境:用 Ollama 或 vLLM 起服务,前置 Nginx 做限流与鉴权,只对内部 IP 开放。
- 接站群:内容生成走内网队列,避免把推理接口暴露给公网,减少被刷与合规风险。
选购时要对比的参数清单:是否为独享资源、带宽是独享还是共享、BGP 路由覆盖哪些欧洲城市、是否有 99.9% 在线率承诺、硬盘是 SSD 还是混存、能否加 IP、是否支持自定义镜像与快照、超额流量怎么计费、故障响应时长。这几项问清楚,比看跑分有用得多。
延迟权衡的三个判断标准
一是看目标市场:主打英国本地,伦敦机房足够;主打德法,要确认路由是否直连法兰克福、阿姆斯特丹。二是看请求类型:批处理内容生成对延迟不敏感,编辑实时交互才需要压到 100ms 以内。三是看抓取体验:Google 抓取欧洲站点时,服务器响应时间超过 500ms 会明显影响抓取预算,这时带宽与线路比 GPU 更关键。
避坑要点与选购推荐
常见坑:把推理接口直接暴露公网被刷爆;选了共享带宽的便宜机型,白天抓取高峰页面打不开;忽略日志留存,客户尽调时拿不出数据处理说明;只买 GPU 不管回源带宽,站群整体体验反而下降。合规上,英国机房部署要明确数据存储位置、访问控制与删除机制,这些写进内部文档即可,不必过度承诺。
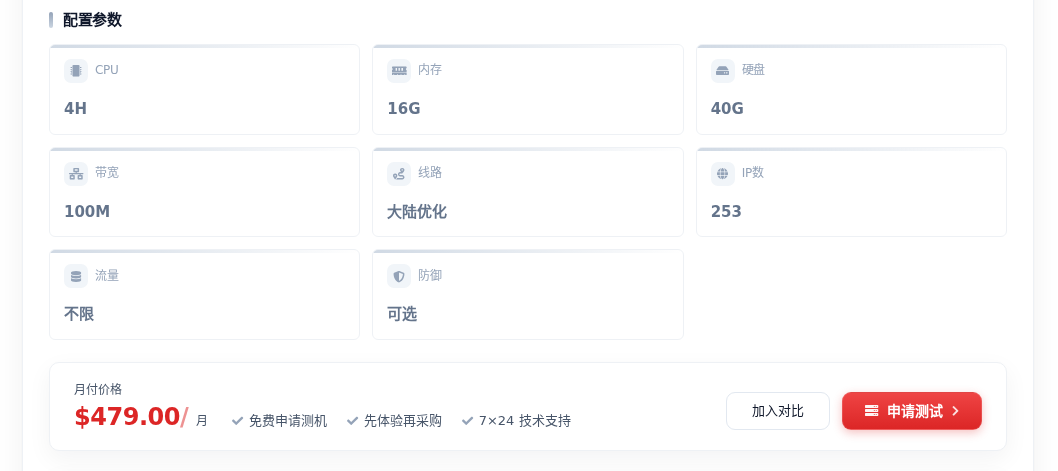
对多数矩阵站群团队,起步阶段不需要上 GPU 物理机,先用一台英国独享云主机跑量化小模型 + 站群回源更划算。英国云站群 I(4H / 16G / 40G / 100M带宽,479 元/月)适合站点数量在几十个以内、以批处理生成内容为主的团队,100M 带宽应对日常抓取够用;如果站点规模上百、图片与页面回源压力大,英国云站群 II(4H / 16G / 50G / 500M带宽,555.00 元/月)多出的带宽对欧洲多国并发访问的体验提升更直接,两者价差不大,建议按回源流量选。
决策建议:先用 API 跑两周,统计真实调用量与并发峰值,再决定是否自建;自建优先选英国独享资源机型,把预算放在带宽与稳定性上,GPU 按需后加。合规文档与推理服务内网化,从第一天就做,后面省事。