怎样从0部署面向欧洲的AI推理服务?英国服务器合规落地与伦敦机房延迟成本横评
做独立站或TikTok Shop欧洲站的团队,一旦把AI客服、RAG商品知识库、AI生成多语言Listing素材这些能力从公有API搬到自建推理,第一个卡点往往不是模型,而是「机器放哪」。欧洲用户对首字节延迟敏感,客服对话超过1秒就开始流失;同时欧盟GDPR对个人数据出境的要求,让把欧洲买家对话传到境外机房变成一件需要解释的事。于是「英国服务器+伦敦机房」成了很多中小团队的现实选项:英语区网络枢纽、到西欧主要城市延迟低、法律体系独立于欧盟但数据充分性认定相对成熟。下面按三种常见落地路径横评。
方案横评:公有API、欧洲云GPU、英国独立服务器
方案A:继续用公有API。优点是零运维、按token计费,适合日均对话量几百条的小卖家。坑在于:欧洲买家数据出境合规需要自查;高峰期限流不可控;长期看单价随调用量线性上涨,做AI批量生成商品图、多语言详情页时账单容易失控。
方案B:欧洲区域云GPU实例。主流云厂商在法兰克福、伦敦、都柏林都有GPU机型,按小时计费,弹性好。适合模型还在选型、流量不确定的阶段。坑在于:单卡月成本量级通常明显高于同规格物理机,长期跑推理不划算;部分区域GPU库存紧张,抢不到卡;公网带宽按流量计费,AI推理返回长文本时带宽费用会咬人。
方案C:英国独立服务器(物理机/独享型云主机)。适合已确定模型(如Llama、Qwen系列7B~14B量化版)、流量稳定的团队。资源独享不超售,延迟和带宽可预期,月成本固定。坑在于:需要自己搭推理框架(Ollama/vLLM等)、自己做运维监控,扩容不如云上灵活。
对跨境电商卖家的实际判断标准:如果AI只做客服问答、日均请求在几千次以内,方案A或B起步;如果同时要跑RAG商品库、批量生成素材、做多语言短剧译制字幕,方案C的固定成本更友好。
伦敦机房延迟与成本怎么算才不踩坑
延迟不能只看机房宣传的「低延迟」,要按真实链路估:伦敦机房到英国本土用户一般在个位数到十几毫秒;到德国、法国、荷兰等西欧核心城市通常在20~40毫秒量级;到南欧、北欧会更高一些。用BGP智能路由的机房,回程线路质量差异明显,选购时应要求服务商提供到目标城市的测试IP,自己用ping和mtr实测,而不是只看标称带宽。
配置估算方法:7B模型4bit量化约需4~6GB显存,14B约8~10GB,加上KV Cache和并发余量,单卡24GB显存可支撑中小并发推理。若用CPU推理或纯做API网关+向量库,4核16G内存级别的机器就能跑起RAG检索层。带宽方面,文本推理单次响应通常几十KB,100M带宽足以支撑相当规模的并发;真正吃带宽的是AI生成图片、视频素材回传,这类场景要按峰值估。
合规落地要点:面向欧盟用户收集的对话数据,存储位置、留存周期、是否用于训练都要在隐私政策里写清楚;选择英国机房时确认服务商的数据中心资质与物理安全措施;涉及支付信息的系统部署要单独隔离。英国机房适合做「欧洲区推理节点+数据暂存」,但数据处理协议仍需自行准备。
选购对比清单与操作步骤
对比英国服务器时按这张清单逐项问:线路(是否BGP智能路由、有无到西欧的测试IP)、资源(是否独享、是否超售、CPU型号与内存代际)、带宽(独享还是共享、超流量怎么计费)、硬盘(SSD还是NVMe、容量是否够放模型权重)、在线率承诺(99.9%是否写进合同)、运维支持(重装、快照、故障响应时效)、合规(机房所在地、数据备份策略)。
落地步骤建议:第一步,用一台低配英国机器跑通Ollama+向量库的RAG链路,验证延迟和效果;第二步,用测试IP实测目标市场延迟,确定机房;第三步,按并发量选显存与带宽,预留30%余量;第四步,把模型权重、知识库、日志分层部署,日志与个人信息分离存储;第五步,上线前做一次压力测试和隐私政策核对。
选购推荐与决策建议
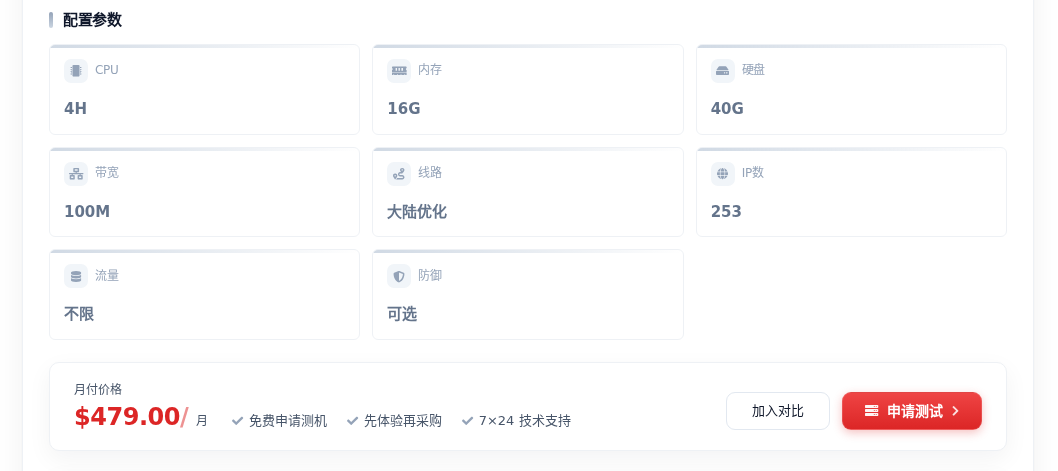
如果团队处于验证期,先用英国云站群 I(4H/16G/40G/100M带宽,479元/月)跑RAG检索层、API网关和轻量推理调度,成本可控,适合先验证欧洲买家的真实延迟与转化效果。若已经确定要把7B~14B量化模型常驻在伦敦节点、同时承担AI客服与素材生成的并发,英国云站群 II(4H/16G/50G/500M带宽,555元/月)的500M带宽更适合图片、视频类素材回传,独享资源不超售也意味着推理响应更稳定。两款均为秀米云英国自营机房、BGP智能路由,库存与配置可选,适合作为欧洲区推理落地的起步机型。
决策建议:先用公有API或低配英国机器验证需求,确认欧洲订单占比和AI调用量后再决定是否把推理常驻伦敦;合规与延迟测试要在采购前完成,不要等上线后再补。