DeepSeek 私有化落地欧洲:英国服务器怎样兼顾 GDPR 与延迟?
做欧洲市场的跨境卖家,最近半年常遇到两个相互冲突的需求:一边是客服团队希望把 DeepSeek、Qwen 这类模型私有化部署,用来做多语言客服和 RAG 知识库,避免把订单、退换货政策、客户邮件喂给第三方 API;另一边是合规同事提醒,欧盟用户的个人数据不能随意出境。两件事叠在一起,问题就变成:推理节点放在英国到底行不行,伦敦机房到欧洲大陆的延迟够不够用。
热点变化:AI 推理从「调 API」转向「自己托管」
过去中小卖家做 AI 客服,多数直接调云端 API,按 token 付费,省事但有两个隐性成本:一是长期调用量上来后账单不透明,二是数据流向难以向客户交代。现在开源模型能力上来,一张 24G 显存的卡就能跑量化后的 7B~14B 模型,很多团队开始考虑自托管。选型逻辑随之变化:不再只比价格,而是比「数据落在哪、延迟多少、断供风险多大」。
英国在这件事上有天然位置优势。伦敦是欧洲金融中心,机房生态成熟,BGP 智能路由到法兰克福、阿姆斯特丹、巴黎通常在十几到二十几毫秒量级,到都柏林、马德里略高。对文本类推理(客服问答、商品描述生成、邮件分类)来说,这个延迟完全够用;对实时语音或数字人直播,才需要更靠近用户的边缘节点。另一个关键点是合规:英国有自己的 UK GDPR,与欧盟 GDPR 框架高度相似但独立适用,数据存放在英国机房,对「欧盟数据不出境」的严格要求来说并非完全等价,但对大量英国本地用户和部分接受英国作为区域枢纽的业务,是常见折中方案。
要配什么机器:显存、带宽与线路怎么估
先算显存。7B 模型 FP16 约需 14G 显存,4bit 量化后 5~6G 可跑;14B 量化后约 9~10G;32B 量化后接近 20G。若同时要跑向量库和 RAG 检索服务,建议留出余量。实操中常见配置量级是:单卡 24G 起步跑 14B 量化模型,服务几十个并发问答;32B 以上或需要微调,则考虑 48G 或双卡。
带宽容易被低估。纯文本推理每次请求往返数据量很小,100M 带宽足以支撑较高 QPS;但如果涉及图片理解、AI 绘画素材回传、短剧译制的音视频处理,出方向带宽会成为瓶颈,500M 级别更稳妥。线路方面,面向欧洲用户优先看机房到欧洲主要 IX 的互联质量,而不是只看「回国优化」——这是英国节点和香港节点选型思路的最大差别。
- 对比清单:机房是否自营、是否独享资源不超售;BGP 路由覆盖哪些欧洲运营商;是否提供 UK GDPR 数据处理说明;GPU 是物理独享还是虚拟切分;带宽是保底还是峰值;在线率承诺与运维响应时效。
- 避坑点:低价「共享 GPU」在多租户下显存和算力波动大,推理延迟不稳定;只写「欧洲机房」不写具体城市的,延迟无法预估;合规文件缺失的机房,后续很难向客户解释数据流向。
落地步骤:从一台机器到可用服务
常规路径是:先在英国节点部署一台带 GPU 或先用 CPU 跑小模型的机器,把 RAG 知识库、多语言客服流程跑通;验证延迟和并发后再决定是否加卡。模型侧可用 Ollama 或 vLLM 做推理服务,前面挂一层网关做鉴权和限流。数据侧要把用户个人数据与模型日志分开存放,日志保留周期写进隐私政策。整个过程的成本量级,一台入门独享服务器通常是每月几百元起,GPU 机型视卡型差异较大,需按实际询价。
对跨境电商卖家,最典型的落地场景是:英国节点跑客服问答与商品文案生成,订单和客户数据留在英国机房,欧洲用户访问延迟可控,同时把 AI 调用成本从按量付费变成固定支出。
选购推荐
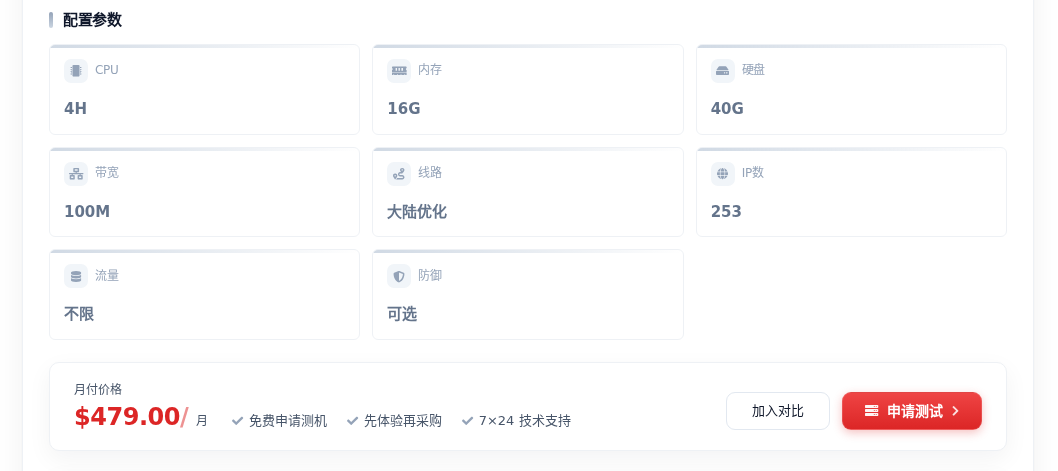
如果现阶段是先跑通 RAG 知识库、多语言客服和轻量推理服务,英国云站群 I(4H / 16G / 40G / 100M 带宽,479 元/月)适合作为起步机型,100M 带宽应付纯文本问答足够,成本可控,适合先验证业务再扩容。若同时要做素材回传、图片处理或并发更高,英国云站群 II(4H / 16G / 50G / 500M 带宽,555 元/月)的带宽余量更从容,价差不大但出方向更宽裕,属于一步到位的选择。两款均为秀米云英国自营机房、BGP 智能路由,库存与配置可选,具体可参考 英国云站群 I 与 英国云站群 II 的配置说明。
决策建议:先用英国节点把合规边界和延迟实测清楚,文本类推理优先,带宽按是否涉及媒体回传来选;GPU 需求明确后再单独评估算力机型,不要一上来就堆卡。