欧洲AI推理服务避坑指南:伦敦机房GPU选型与延迟实测成本账
一、先算账:在欧洲跑AI推理,钱到底花在哪?
个人站长或自媒体博主想在欧洲上线一个AI应用——可能是基于Llama或Qwen的私有化知识库问答,也可能是AI绘画生成头像、短剧译制字幕的自动翻译——第一反应往往是“租张GPU卡”。但真正落地时,账单会拆成四块:算力、带宽、存储与合规。
- 算力成本:云GPU按小时计费,单卡T4或A10级别通常每小时几元到十几元不等,月跑满则数千元;物理机独享GPU月租一般在数千元量级,视显卡型号与服务商而定。对于流量不大的个人项目,先用云GPU按需跑通,再考虑长租物理机是更稳妥的路径。
- 带宽成本:欧洲用户访问推理API,延迟敏感。伦敦机房到法兰克福、巴黎、阿姆斯特丹的BGP直连延迟通常在10-20ms,到马德里、罗马约30-40ms。若带宽不足,排队和超时会直接劝退用户。100M独享带宽与500M共享带宽的月费差距可能只有几十到一百多元,但体验差距明显。
- 存储成本:模型权重动辄十几GB到上百GB,加上日志和用户上传的图片/音频,50G系统盘往往不够。建议模型文件放对象存储或独立数据盘,系统盘只装推理框架。
- 合规成本:面向欧洲用户,GDPR是绕不开的。用户数据若涉及欧盟公民,需明确数据存储位置与处理协议。选择英国机房时,确认服务商是否提供数据处理协议(DPA)模板,以及机房是否在英国境内——英国脱欧后有自己的数据保护法,但与欧盟的充分性认定仍在,通常比直接选美国机房更省心。
以一个日活500人的AI问答小站为例,月成本量级大致在500-1500元(轻量云服务器+按需GPU或纯CPU推理小模型),若换成7B以上模型常驻GPU,则月成本会跳到3000-6000元区间。先想清楚模型大小和并发量,再决定机器档次。
二、GPU选型避坑:显存不是唯一指标,但先算显存
选GPU时最容易踩的坑是“只看算力不看显存”。模型加载不进显存,算力再高也白搭。估算公式很简单:FP16精度下,显存占用约等于参数量×2GB。例如7B模型约需14GB显存,13B约26GB,70B则需140GB以上(需多卡或量化)。实际推理还要留出KV Cache和框架开销,通常再加20%-30%余量。
- 7B以下模型:一张16GB显存的卡(如T4、A4000)即可,适合个人站长做轻量客服机器人或内容摘要。
- 7B-13B模型:建议24GB显存起步(如A10、RTX 4090),量化到INT8可进一步降低显存需求,但精度会略降。
- 70B级别:通常需要多卡或INT4量化,个人项目不建议自建,优先考虑API调用或按需租用多卡实例。
另一个坑是忽略CPU推理的可行性。如果只是做文本分类、情感分析或小参数量的Embedding检索,现代CPU配合ONNX Runtime或llama.cpp,在4核16G的机器上也能跑出可接受的吞吐。对于自媒体博主做RAG知识库,检索部分用CPU、生成部分调API,成本会比全GPU方案低一个数量级。
伦敦机房的优势在于BGP智能路由:对欧洲用户,回程线路优化后延迟抖动更小;对国内管理后台,也能保持可用的连接质量。实测中,伦敦到都柏林、法兰克福的TCP握手延迟通常在15ms以内,比绕道美国西海岸的150ms以上体验好得多。
三、延迟实测与配置清单:别为用不上的带宽买单
部署前建议做三件事:测延迟、压并发、看线路。
- 测延迟:用ping和curl从目标用户所在城市(如伦敦、柏林、巴黎)的监测点测试机房IP,关注平均延迟和丢包率。伦敦机房到欧洲主要城市通常应在40ms以内,若超过60ms,检查是否走了绕行线路。
- 压并发:用ab或wrk对推理API做简单压测,观察P95延迟。对于流式输出(SSE),首token延迟比总时长更影响体验,通常要求首token在1秒内返回。
- 看线路:确认服务商是否提供BGP多线接入,以及是否对欧洲本地ISP有优化。英国机房若只接单一运营商,高峰期可能拥塞。
配置清单(个人站长/自媒体博主适用):
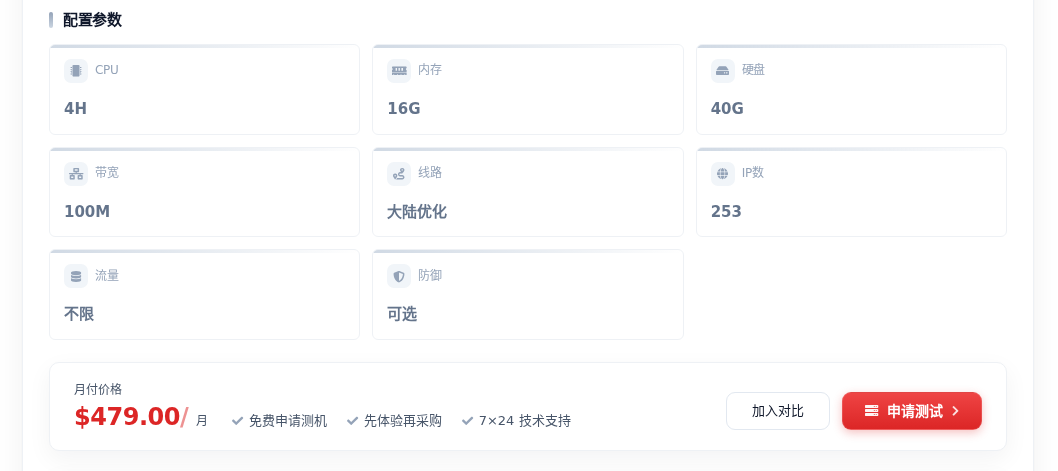
- 入门级:4核16G、40G系统盘、100M带宽,跑7B以下量化模型或CPU推理,适合日请求量几千次的小型AI客服或内容生成工具。
- 进阶级:4核16G、50G系统盘、500M带宽,适合需要处理图片/音频上传、或并发稍高的场景(如AI头像生成、短剧字幕翻译),大带宽能减少文件传输等待。
- GPU附加:若必须GPU,优先选支持按小时计费的云GPU实例,跑通后再考虑长租;物理GPU服务器月租通常数千元,个人项目需谨慎评估ROI。
避坑要点:不要被“无限流量”迷惑,很多低价方案限制CPU占用或I/O,推理服务很容易触发限制;确认是否独享资源,超售的机器在高峰期延迟会飙升;问清DDoS防护,AI服务暴露公网后可能遭遇恶意请求,基础防护通常够用,但要有。
四、选购推荐:轻量推理场景的务实之选
结合上述成本与延迟考量,对于大多数个人站长和自媒体博主,起步阶段不必追求GPU物理机,一台网络质量好、资源独享的英国云服务器足以跑通MVP。秀米云英国机房提供BGP智能路由和99.9%在线率保障,适合面向欧洲用户的轻量推理服务。
若模型规模在7B以下、以文本推理为主,推荐英国云站群 I(4H/16G/40G/100M带宽,479元/月),100M带宽应对日常API请求足够,16G内存可承载量化后的7B模型或CPU推理方案,成本可控。
若涉及图片、音频上传或并发稍高,推荐英国云站群 II(4H/16G/50G/500M带宽,555.00元/月),500M带宽能显著缩短文件传输时间,50G系统盘也为模型文件和日志留出更多空间,月费仅多几十元,性价比更高。
决策建议:先用低配机器跑通推理链路并实测欧洲用户延迟,确认模型和并发量后再决定是否加GPU。伦敦机房的低延迟BGP线路是面向欧洲市场的务实起点,合规上保留数据处理记录,避免因小失大。