欧洲用户跑AI推理,伦敦机房合规与延迟如何权衡选型
热点变了:AI推理落地欧洲,选型逻辑跟着变
DeepSeek、Llama、Qwen 这类模型开源之后,个人站长和自媒体博主也能自建 AI 客服、RAG 知识库、AI 写作助手或短剧译制流水线。但一旦用户主要在欧洲,问题就不再是「显卡够不够」,而是「数据放在哪、延迟能不能忍」。英国脱欧后沿用 UK GDPR,与欧盟 GDPR 并行适用,用户数据跨境传输需要合法性基础;同时欧洲用户对首字延迟(TTFT)非常敏感,跨洲调用往往多出 150ms 以上。伦敦机房因此成为折中点:既是欧洲金融中心,国际带宽与 BGP 智能路由成熟,又处在欧洲网络枢纽位置,到法兰克福、巴黎、阿姆斯特丹通常在 10~20ms 量级。
先判断合规:哪些推理请求不能随便出境
- 看数据类别:只做公开内容的摘要、翻译、素材生成,合规压力小;一旦涉及用户账号、订单、聊天记录,就属于个人数据处理,建议数据与推理都在英国境内完成。
- 看是否跨境:把欧洲用户数据传到美国或亚洲节点推理,需要合同条款、用户告知等支撑,个人站长通常没有精力维护,不如直接选伦敦本地机房。
- 看日志留存:推理服务的 prompt 与输出是否落盘、落盘在哪,要在部署前想清楚。选择独享资源的物理或云主机,数据边界比共享型 API 更清晰。
- 看服务商:机房是否在英国本地、是否提供独立 IP 与资源隔离,通常比一句「符合 GDPR」更有意义,具体合规责任仍在使用者一侧。
再估延迟与配置:要多大机器才够
延迟分两段:网络 RTT 与推理耗时。面向欧洲用户,伦敦机房到主要城市一般在 10~30ms,属于可接受区间;如果选在更远的地区,单程就可能超过 100ms。推理耗时取决于模型规模与量化方式:7B 级模型用 4-bit 量化,显存通常需要 6~8GB 起步;13B 级大致 10~16GB;如果只是做 RAG 检索加小模型改写,CPU 加少量显存也能跑,但并发一高就顶不住。
对个人站长更现实的做法是「前端轻、后端稳」:把向量库、Web 服务、调度层放在英国服务器上,GPU 推理可以先用云 GPU 按量计费试水,等日请求量稳定后再考虑物理机。带宽方面,文本推理单请求很小,100M 带宽足以支撑相当规模的并发;真正吃带宽的是 AI 绘画、数字人、短剧译制这类大文件传输,此时 500M 带宽的机型更从容。费用量级上,英国云主机入门配置通常每月几百元起,GPU 云实例按卡时计费,物理机则视显卡型号而定,整体属于「先小额验证、再逐步加码」的节奏。
选购参数清单:对照着问服务商
- 机房位置:是否真在伦敦,而非「英国节点」转售。
- 线路类型:是否 BGP 智能路由,到欧洲主要城市延迟能否给出实测。
- 资源是否独享:CPU、带宽是否超售,直接决定推理稳定性。
- IP 与端口:是否独立 IP、能否自定义端口,方便做多服务隔离。
- 带宽与流量:是固定带宽还是峰值计费,大文件场景要看清。
- 在线率与运维:是否承诺 99.9% 在线率、故障响应方式。
- 扩展性:后续能否升配、加盘、加 IP。
- 合规配合:能否提供发票、合同等基础材料。
避坑要点:不要只看「英国」两个字,要确认数据中心城市;不要用共享型低价机跑持续推理,CPU 抢占会让 TTFT 抖动明显;不要把训练和推理混在同一台机器上,显存与 IO 会互相拖累。
选购推荐
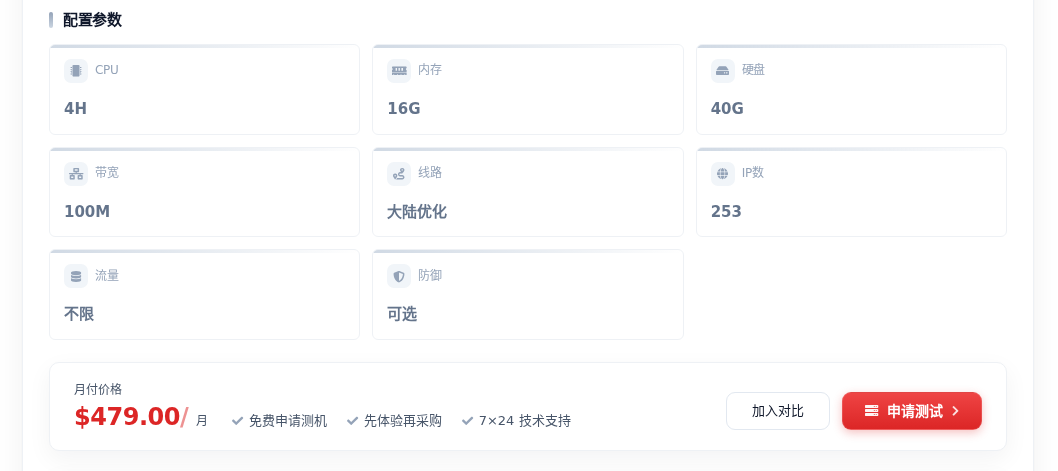
如果推理服务的前端、RAG 检索层和调度服务放在伦敦,秀米云英国服务器是贴合本文场景的选择:欧洲金融中心自营机房、低延迟 BGP 智能路由、企业级硬件独享资源不超售,适合对稳定性和数据边界有要求的小团队。轻量起步可看 英国云站群 I,4H/16G/40G/100M 带宽,479 元/月,跑 Web 服务、向量库和小模型调度足够;若还要承载 AI 绘画素材、短剧译制成品的分发,英国云站群 II 的 4H/16G/50G/500M 带宽、555.00 元/月更从容,大文件传输不易成瓶颈。
决策建议
面向欧洲用户的 AI 推理,优先级应是「合规边界清晰 > 延迟可接受 > 配置够用」。数据涉及个人信息就放伦敦本地,先用云主机跑通前端与检索,再按请求量决定是否上 GPU;带宽按业务类型选 100M 或 500M,别为峰值场景长期买单。